Como rodar modelos como Llama, Qwen, Gemma e DeepSeek 100% offline no seu próprio hardware — privacidade total, custo zero por token.
Por que rodar IA localmente em 2026?
Você já parou pra pensar no seguinte: toda vez que você manda uma mensagem pro ChatGPT, Claude ou Gemini, seus dados viajam pela internet até os servidores de uma empresa? Documentos confidenciais, código-fonte proprietário, informações de clientes — tudo sai da sua máquina.
Rodar LLMs (Large Language Models) localmente resolve três problemas reais:
- Privacidade absoluta: nenhum dado sai do seu hardware. Ideal para documentos sensíveis, código proprietário, dados de clientes, ambientes sujeitos a LGPD ou GDPR.
- Custo zero por token: depois do investimento inicial no hardware, não há cobrança por requisição. Você roda quantas vezes quiser, sem surpresa na fatura.
- Funciona offline: sem internet, sem API que cai, sem rate limiting, sem mudanças de modelo sem aviso.
E o melhor: o ecossistema amadureceu tanto que hoje é mais fácil do que parece.
A Revelação: Três Ferramentas, Um Único Motor
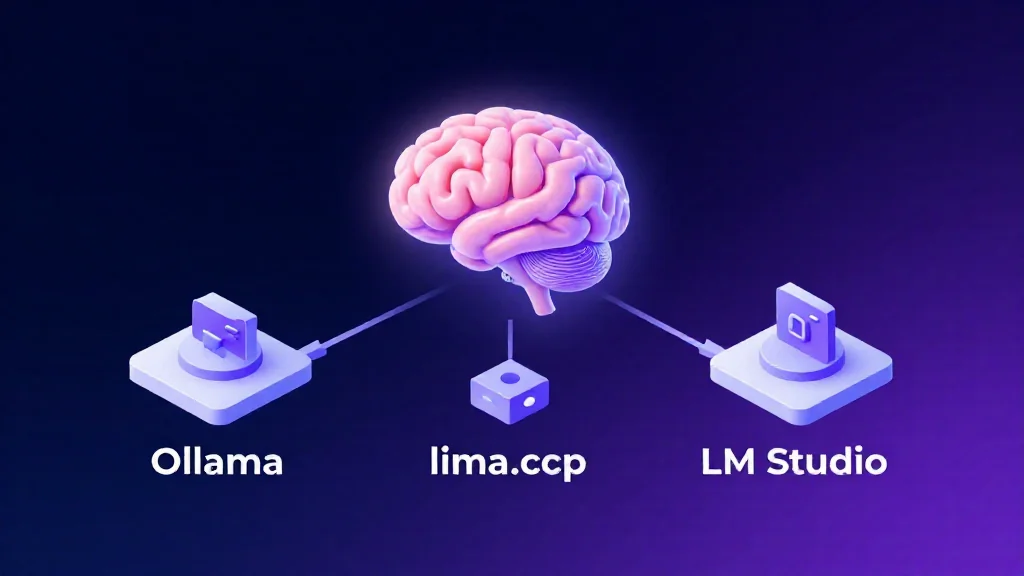
Aqui está o insight mais importante deste artigo, e que muita gente não entende: Ollama e LM Studio rodam o llama.cpp por baixo dos panos.
Ou seja, não são três competidores — são três camadas sobre o mesmo engine. O llama.cpp é o motor de inferência em C/C++ que faz o cálculo pesado, com mais de 121 mil estrelas no GitHub. O Ollama é um CLI e daemon escrito em Go (com mais de 177 mil estrelas no GitHub) que embrulha o llama.cpp, gerencia modelos e expõe uma API. O LM Studio é um aplicativo desktop (Electron) com interface gráfica, navegador de modelos integrado ao Hugging Face e servidor API.
A analogia é simples: llama.cpp é o motor, Ollama é o painel de controle por comando, LM Studio é o carro completo com GPS e ar-condicionado. Os três suportam o formato GGUF e os três expõem API compatível com a da OpenAI.
Formato GGUF e Quantização
O que é GGUF?
GGUF (GPT-Generated Unified Format) é o formato de arquivo criado pela equipe do llama.cpp para armazenar modelos de linguagem de forma otimizada para inferência. Um único arquivo .gguf contém os pesos do modelo (quantizados ou não), o tokenizer, o template de chat e metadados como arquitetura, parâmetros e contexto. Isso significa que você baixa um arquivo e está pronto para rodar.
Quantização: o que são aqueles nomes estranhos?
Modelos originais usam números de 16 ou 32 bits para cada peso. Um modelo de 8 bilhões de parâmetros (8B) em formato original (FP16) ocupa aproximadamente 16 GB. A quantização reduz a precisão de cada peso, encolhendo o modelo drasticamente com perda mínima de qualidade.
A documentação oficial do llama.cpp traz uma tabela completa de tamanhos e velocidades de referência. Os números variam conforme o hardware, então use a ferramenta llama-bench no seu próprio equipamento para obter valores reais.
- Q4_K_M — 4,89 bits/peso, 4,58 GiB, geração a 71,93 tokens/segundo no benchmark de referência
- Q5_K_M — 5,70 bits/peso, 5,33 GiB, geração a 67,23 t/s
- Q6_K — 6,56 bits/peso, 6,14 GiB, geração a 58,67 t/s
- Q8_0 — 8,50 bits/peso, 7,95 GiB, geração a 50,93 t/s
- F16 (sem quantização) — 16 bits/peso, 14,96 GiB, geração a apenas 29,17 t/s
Recomendação prática: comece sempre com Q4_K_M. É o melhor equilíbrio entre qualidade e tamanho — um modelo de 8B cabe em aproximadamente 5 GB de RAM ou VRAM e mantém excelente qualidade. Se tiver memória sobrando, suba para Q5_K_M ou Q6_K.
Existem três famílias principais de quantização documentadas oficialmente. As K-quants (Q4_K_M, Q5_K_M, Q6_K) são o padrão recomendado atualmente e distribuem os bits de forma inteligente entre as camadas. As Legacy quants (Q4_0, Q4_1, Q8_0) são o método mais antigo e direto — Q8_0 ainda oferece qualidade praticamente idêntica ao original, mas a maioria dos modelos modernos no Hugging Face já vem em K-quants. As I-quants (IQ2, IQ3, IQ4) são para ultra-compressão quando o VRAM é extremamente limitado, usando lookup tables que podem ser mais lentas em hardware sem poder de computação suficiente.
Ferramenta 1: llama.cpp — Controle Total, Máxima Performance
Inferência de LLM CPU-first com offload opcional para CUDA (NVIDIA), Metal (Apple Silicon), Vulkan, SYCL (Intel), entre outros. Compila em CMake puro, sem dependências pesadas. Licença MIT. Suporta inferência em F16 e quantizada, API compatível com OpenAI, multimodal (visão), function calling, speculative decoding e continuous batching.
Build (compilação)
Para CPU apenas, clone o repositório, entre na pasta e rode os comandos do CMake:
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build
cmake --build build --config Release -j
Para GPU NVIDIA (CUDA), adicione a flag -DGGML_CUDA=ON no primeiro cmake. No macOS, o Metal é ativado por padrão.
Binários que você vai usar
llama-cli— chat e CLI interativo para geração de texto e benchmarksllama-server— servidor HTTP com Web UI e API compatível com OpenAIllama-quantize— quantiza modelos GGUF de FP16 para K-quantsllama-bench— benchmark de throughput e latência
Exemplo: servidor API local
./build/bin/llama-server \
  -m models/Llama-3.1-8B-Instruct-Q4_K_M.gguf \
  --host 0.0.0.0 --port 8080 \
  -c 8192 -ngl 99 -t 8 \
  --cache-type-k q8_0 --cache-type-v q8_0
Principais flags documentadas oficialmente: -m ou --model define o caminho para o arquivo GGUF. -c ou --ctx-size define o tamanho do contexto em tokens. -ngl ou --n-gpu-layers define quantas camadas vão para a GPU (99 significa todas). -t ou --threads define os threads de CPU. --host e --port definem o endereço e porta do servidor. --cache-type-k e --cache-type-v definem a quantização do cache KV. -fa ativa o Flash Attention.
Ferramenta 2: Ollama — Um Comando, Tudo Funcionando
Daemon escrito em Go que embarca o llama.cpp como engine de inferência. Adiciona uma camada de gerenciamento com registry de modelos (como um Docker Hub para LLMs), API REST, Modelfiles customizáveis e compatibilidade nativa com a API da OpenAI. Disponível para macOS, Windows e Linux.
Comandos essenciais
# Baixar um modelo
ollama pull llama3.1:8b

# Rodar e conversar
ollama run llama3.1:8b

# Listar modelos
ollama list

# Subir o daemon (servidor API)
ollama serve

# Criar modelo customizado a partir de um Modelfile
ollama create meu-modelo -f Modelfile
A biblioteca de modelos (ollama.com/library)
O Ollama mantém um registry público com modelos pré-quantizados. Llama 3.1 tem 117 milhões de pulls. DeepSeek-R1 tem 90 milhões. Gemma 3 tem 38,7 milhões. Qwen 2.5 tem 35 milhões. Qwen 3 tem 32,4 milhões. Mistral tem 31,2 milhões. Gemma 4 tem 18,8 milhões. gpt-oss tem 11 milhões. Cada modelo tem múltiplas tags para diferentes tamanhos e quantizações.
Nota importante: o Ollama usa Q4_0 como padrão da tag latest. Para usar Q4_K_M especificamente, busque a tag exata na página do modelo em ollama.com/library.
Modelfile: personalização poderosa
O Modelfile funciona como um Dockerfile para modelos. Você define modelo base, parâmetros como temperature, top_p, top_k, num_ctx e num_gpu, além do system prompt. Depois é só criar com ollama create e rodar com ollama run.
API compatível com OpenAI
O Ollama expõe endpoints compatíveis com a API da OpenAI na porta 11434. A base URL é http://localhost:11434/v1 e a API key pode ser qualquer string (é obrigatória mas não validada). O mesmo código que fala com a OpenAI funciona — basta trocar a URL base.
Ferramenta 3: LM Studio — Interface Gráfica + API + RAG
Aplicativo desktop que oferece navegador de modelos integrado ao Hugging Face com busca, filtro por quantização e download com um clique. Tem interface de chat com ajuste visual de parâmetros, servidor API compatível com OpenAI na porta 1234, chat com documentos (RAG local totalmente offline), suporte a GGUF via llama.cpp e MLX no Apple Silicon, cliente MCP (Model Context Protocol) e modo headless para servidores e CI.
Requisitos de sistema
- macOS: Apple Silicon (M1 a M4), macOS 14 ou superior, 16 GB de RAM recomendados (8 GB roda modelos pequenos). Macs Intel não são suportados.
- Windows: processador x64 com suporte a AVX2 ou ARM64, 16 GB de RAM, pelo menos 4 GB de VRAM dedicada.
- Linux: x64 com AVX2 ou ARM64, distribuído como AppImage, Ubuntu 20.04 ou superior.
Como usar
Baixe em lmstudio.ai/download. Abra o app e pressione Ctrl+Shift+R para gerenciar runtimes. Na aba Discover (Ctrl+2), busque modelos no Hugging Face, filtre por GGUF e escolha a quantização. Na aba Chat, selecione o modelo, converse e ajuste parâmetros. Na aba Developer, clique em Start Server para a API ficar disponível em localhost:1234.
Tutorial Prático: Mesmo Modelo, Três Caminhos
Caminho A — Ollama (mais rápido para começar)
Instale o Ollama, baixe o modelo com ollama pull llama3.1:8b, converse com ollama run llama3.1:8b, e suba como API com ollama serve. A API fica disponível em http://localhost:11434/v1.
Caminho B — llama.cpp direto (controle máximo)
Clone o repositório, compile com CMake (adicionando -DGGML_CUDA=ON se tiver GPU NVIDIA), baixe o modelo GGUF do Hugging Face, e suba o servidor com llama-server passando o caminho do modelo, host, porta, tamanho de contexto, camadas de GPU e threads. A API fica disponível em http://localhost:8080/v1.
Caminho C — LM Studio (mais visual)
Baixe e instale o LM Studio. Na aba Discover, busque o modelo, filtre por GGUF, escolha Q4_K_M e faça o download. Na aba Chat, selecione o modelo e converse. Para API, vá na aba Developer e clique em Start Server. Para RAG, arraste um PDF para o chat, ative a opção e faça perguntas sobre o documento.
Quantização na Prática: Como Escolher
Regra de ouro: comece com Q4_K_M. Sempre. Se o modelo couber na sua memória e você quiser mais qualidade, suba gradualmente para Q5_K_M, Q6_K e Q8_0.
Para um modelo de 8B parâmetros como Llama 3.1 8B, a quantização Q4_K_M ocupa aproximadamente 4,9 GB e precisa de uns 6 GB de RAM ou VRAM com contexto de 4K tokens, com excelente qualidade. A Q5_K_M ocupa 5,3 GB e precisa de 7 GB. A Q6_K ocupa 6,1 GB e precisa de 8 GB. A Q8_0 ocupa 7,9 GB e precisa de 10 GB, com qualidade praticamente sem perda.
Dica de performance: ative a quantização do cache KV com --cache-type-k q8_0 e --cache-type-v q8_0 para reduzir o consumo de memória do contexto aproximadamente pela metade (de f16 para q8_0), com perda mínima de qualidade.
Tabela Comparativa: Qual Usar?
O llama.cpp oferece controle máximo com interface de linha de comando bare metal, ideal para engenheiros e quem está construindo produtos. O Ollama oferece a facilidade de um único comando, com daemon leve para CI/CD e gerenciamento de modelos como containers. O LM Studio oferece interface gráfica completa, com navegador de modelos integrado e RAG local nativo.
Os três suportam API compatível com OpenAI. Ollama na porta 11434, LM Studio na 1234, e llama.cpp em qualquer porta que você definir.
- Use Ollama se você é desenvolvedor e quer o caminho mais rápido para rodar e integrar modelos.
- Use LM Studio se prefere interface gráfica ou precisa de RAG local sem programar.
- Use llama.cpp diretamente se precisa de controle máximo sobre performance e flags, ou está construindo algo em cima do engine.
Integração com Código: Tudo Funciona com o SDK da OpenAI
Como os três expõem API compatível com a OpenAI, o mesmo código Python funciona — só muda a base_url. Para Ollama use http://localhost:11434/v1. Para LM Studio use http://localhost:1234/v1. Para llama.cpp use http://localhost:8080/v1.
Isso significa que qualquer framework que suporte a API da OpenAI — LangChain, LlamaIndex, AutoGen, CrewAI, LiteLLM, OpenWebUI, Vercel AI SDK — funciona nativamente. Basta trocar a URL base.
Dicas de Performance
- GPU Offload é o maior ganho individual: use
-ngl 99(todas as camadas) sempre que possível. Mover o processamento da CPU para a GPU tipicamente multiplica o throughput por vários fatores — meça com llama-bench antes e depois. - Threads CPU: devem corresponder ao número de núcleos físicos, não lógicos. Usar todos os threads com hyperthreading não ajuda e pode atrapalhar.
- Contexto custa memória: um contexto de 32K tokens consome muito mais VRAM ou RAM que 4K. Dimensione conforme sua necessidade real.
- KV Cache quantizado: ative q8_0 no cache KV para reduzir o consumo de memória do contexto aproximadamente pela metade, com perda mínima de qualidade.
- Flash Attention: ative com
-fa onem hardware moderno para kernels de atenção otimizados. - Speculative decoding no llama.cpp: use um modelo pequeno como draft com a flag
-mdpara acelerar a geração do modelo grande. Os ganhos variam conforme o hardware e o par de modelos — meça com llama-bench.
Conclusão
O ecossistema de IA local amadureceu. Você não precisa mais escolher entre privacidade e qualidade — as três ferramentas rodam os mesmos modelos de ponta com performance impressionante em hardware de consumo.
O motor é o mesmo, llama.cpp. A diferença está na interface: quer CLI poderoso? Ollama. Prefere GUI bonita? LM Studio. Precisa de controle absoluto? llama.cpp direto. E como todos falam a API da OpenAI, seu código não precisa mudar quando você troca de ferramenta.
Comece hoje: instale o Ollama com ollama pull llama3.1:8b e ollama run llama3.1:8b. Baixe o LM Studio e explore o navegador de modelos. Compile o llama.cpp e rode llama-bench no seu hardware.
Referências oficiais: github.com/ggml-org/llama.cpp, github.com/ollama/ollama, ollama.com/library, lmstudio.ai/docs